

Una ricetta tedesca richiede “ein Pfund Mehl”. La maggior parte delle persone, e anche la maggior parte dei modelli di IA, lo interpreta come una libbra di farina. In Germania, però, un Pfund corrisponde a 500 grammi, circa il 10% in più di una libbra imperiale. Gemini 3.1 Pro l’ha tradotto come “a pound of flour” (una libbra di farina). La frase si legge benissimo. La torta viene sbagliata.
Errori come questo passano inosservati perché il risultato sembra scorrevole. Il Last Translation Benchmark è stato creato proprio per raccogliere questi casi. Al 20 ottobre 2026, Lara 3 Think, il modello di ragionamento di Lara Translate, è in cima alla classifica con un tasso di superamento del 56,09%. Ecco come funziona il benchmark, come si confrontano i punteggi e quando vale la pena aspettare qualche secondo in più per il ragionamento.
TL;DR
- Cosa: il Last Translation Benchmark è un test accademico sulla traduzione con l’IA. Il suo set di valutazione, composto da 911 elementi, è costruito con frasi che i sistemi di traduzione IA sbagliano.
- Risultato: Lara 3 Think è in testa alla classifica Blind con il 56,09%, quasi 11 punti sopra GPT-6 Astra Pro (45,33%).
- Inoltre: Lara 2 Think Pro si piazza al terzo posto con il 44,90%, quindi Lara Translate occupa due delle prime tre posizioni.
- In sintesi: con slang, modi di dire e riferimenti culturali, a fare la differenza tra il sistema migliore e gli altri è una fase di ragionamento prima della traduzione.
RISPOSTA RAPIDA
Lara 3 Think ottiene il 56,09% nel Last Translation Benchmark (LTBv1-eval, modalità Blind), il tasso di superamento più alto tra tutti i sistemi di IA in classifica al 20 ottobre 2026. GPT-6 Astra Pro è secondo con il 45,33%, mentre Lara 2 Think Pro è terzo con il 44,90%. Ogni elemento del benchmark è stato scelto perché i principali sistemi di traduzione IA lo sbagliavano, quindi il distacco mostra quanto bene ogni sistema gestisce slang, modi di dire e riferimenti culturali.
Perché è importante: gli errori di traduzione più difficili sono quelli che suonano bene: una “libbra” di farina che dovrebbe essere 500 grammi, un modo di dire reso parola per parola. Nessuno li segnala finché non lo fa un cliente o un tribunale. Un benchmark costruito esclusivamente con queste trappole mette in luce quali sistemi capiscono davvero il significato, e i risultati dimostrano che una fase di ragionamento prima della traduzione è ciò che colma il divario.
Cos’è il Last Translation Benchmark?
Il Last Translation Benchmark (LTB) è un progetto accademico guidato da Vilém Zouhar, con ETH Zurich tra le istituzioni principali. Riunisce 260 contributori provenienti da 177 istituzioni. La prima versione, LTBv1, include 3.456 esempi scritti da persone e sottoposti a peer review in 109 lingue, tra testi, immagini, audio e video.
La regola di selezione è rigorosa. Un esempio veniva accettato solo se la maggior parte dei principali sistemi di traduzione automatica lo sbagliava. Perché tanta severità? Secondo gli autori, i benchmark di traduzione esistenti sono ormai vicini alla saturazione, quindi serviva un test più difficile per distinguere i sistemi migliori.
Il risultato punta molto sul linguaggio informale e legato alla cultura. Nell’intero dataset, le etichette dello studio includono 986 riferimenti culturali e 453 espressioni gergali. La classifica valuta i modelli su LTBv1-eval, un sottoinsieme di 911 elementi di solo testo.
Come viene valutato il Last Translation Benchmark
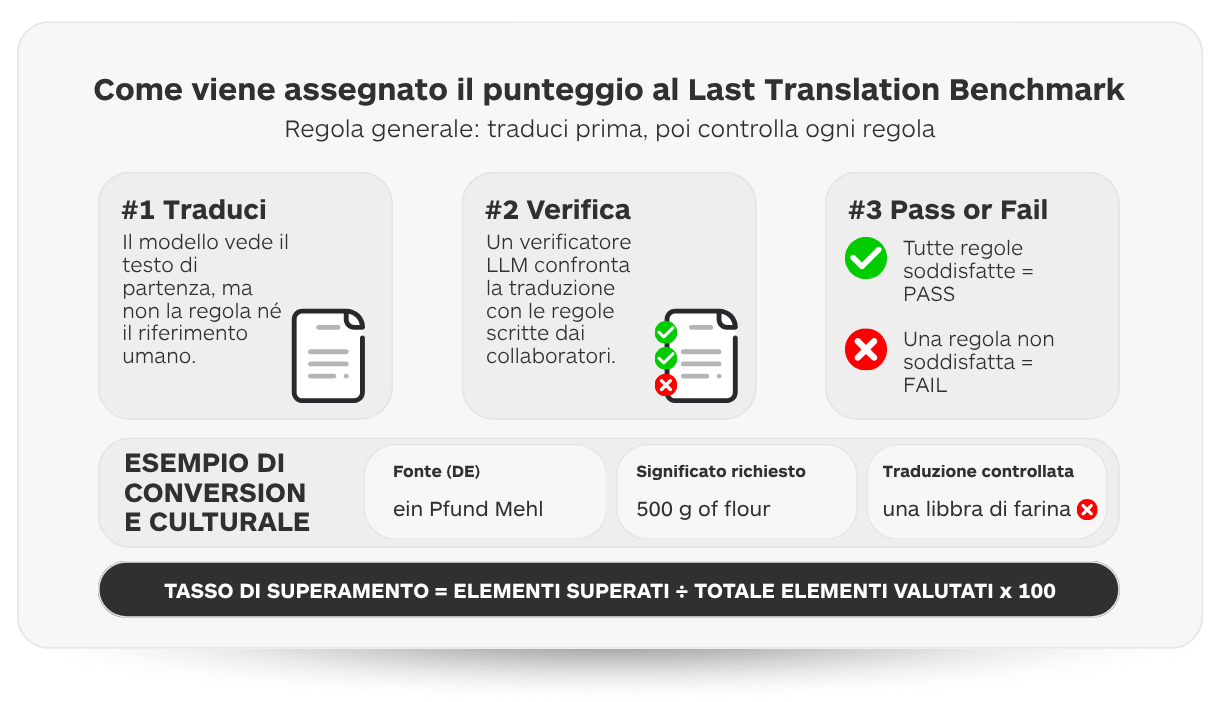
Ogni esempio include regole di superamento scritte dal contributore che lo ha inviato. Una regola può stabilire che “Pfund” deve diventare 500 g, oppure che un proverbio deve mantenere il suo significato figurato. Una traduzione supera il test solo se rispetta tutte le regole.
Un LLM controlla ogni traduzione rispetto a quelle regole. La classifica live usa attualmente Gemini 3.8 Flash come verificatore, mentre la verifica interattiva dello studio ha usato Gemini 3.1 Pro. Lo studio riporta un Kendall τb di 90,5 (su una scala da 0 a 100) tra le classifiche dei sistemi prodotte dal verificatore e quelle umane. Raccomanda inoltre di usare LLM open source come verificatori per la massima riproducibilità.
Anche i finanziamenti sono dichiarati. Lo studio ringrazia Cohere, Google e OpenAI per il supporto economico che ha permesso di gestire la piattaforma su larga scala, e la Charles University per l’infrastruttura server.
La classifica ha due modalità. Tutti i dati di questo articolo provengono dalla modalità principale, Blind, in cui i modelli traducono senza vedere né le regole né il riferimento umano.
Risultati del Last Translation Benchmark (ottobre 2026)
I migliori sistemi di IA su LTBv1-eval, modalità Blind, al 20 ottobre 2026. Fonte: classifica LTB.
| Posizione | Modello | Azienda | Tasso di superamento |
|---|---|---|---|
| 1 | Lara 3 Think | Translated | 56,09% |
| 2 | GPT-6 Astra Pro | OpenAI | 45,33% |
| 3 | Lara 2 Think Pro | Translated | 44,90% |
| 4 | GPT-6 Astra | OpenAI | 44,02% |
| 5 | Gemini 4 Argon | 40,94% | |
| 6 | Gemini 3.8 Flash | 39,85% | |
| 7 | Gemini 3.1 Pro | 39,30% | |
| 8 | Claude Fable 5.1 | Anthropic | 32,93% |
Le traduzioni umane dei contributori del benchmark ottengono il 99,89%, che rappresenta il tetto massimo.
Lara 3 Think supera il sistema successivo di quasi 11 punti percentuali. Sono circa 98 frasi in più tradotte correttamente su 911, in un test in cui ogni elemento è stato scelto proprio perché i sistemi più avanzati lo sbagliavano. Lara 3 Think è stato eseguito con lo stile Fluid e senza alcun adattamento: niente contesto, memorie di traduzione, glossari o istruzioni personalizzate.
Una breve nota sui nomi. Lara Think è la modalità di ragionamento di Lara Translate. Lara 3 Think è la versione attuale, basata su Lara 3, mentre Lara 2 Think Pro appartiene alla generazione precedente.
Prova Lara Think sulle frasi che mettono in difficoltà gli altri strumenti
Incolla recensioni piene di slang, testi di marketing ricchi di modi di dire o una clausola contrattuale complicata, e confronta il risultato riga per riga.
Perché Lara Base e Lara Think ottengono punteggi così diversi?
La stessa classifica riporta un modello Lara standard precedente (una voce di novembre 2025) allo 0,66%. Quel dato dice più su come è andata l’esecuzione che sulla qualità delle traduzioni. I nostri log di quelle esecuzioni del benchmark mostrano una lunga lista di errori tecnici, dovuti soprattutto alle differenze tra i formati di input standard che Lara Translate si aspetta e quelli usati per eseguire il benchmark. Il dataset pubblico lo conferma: per 200 dei 911 elementi di valutazione non c’è alcun output di Lara, e ognuno di questi conta come non superato.
Stiamo lavorando con il team del benchmark per sistemare l’integrazione e ripetere la valutazione, così la classifica rifletterà ciò che Lara Translate offre davvero.
Cos’è Lara Think e come funziona?
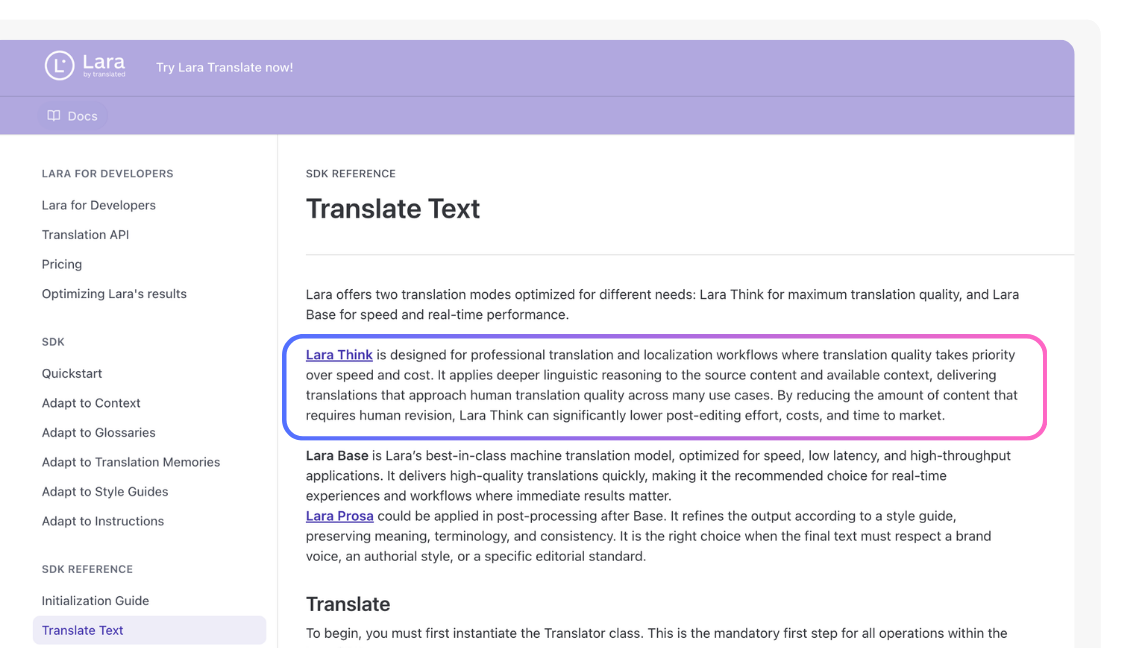
Lara Think è il modello di ragionamento di Lara Translate. Prima di scegliere una traduzione, esegue un’analisi linguistica del testo di partenza in più fasi, tiene conto di glossari, guide di stile e contesto quando sono disponibili, e poi rivede il proprio output.
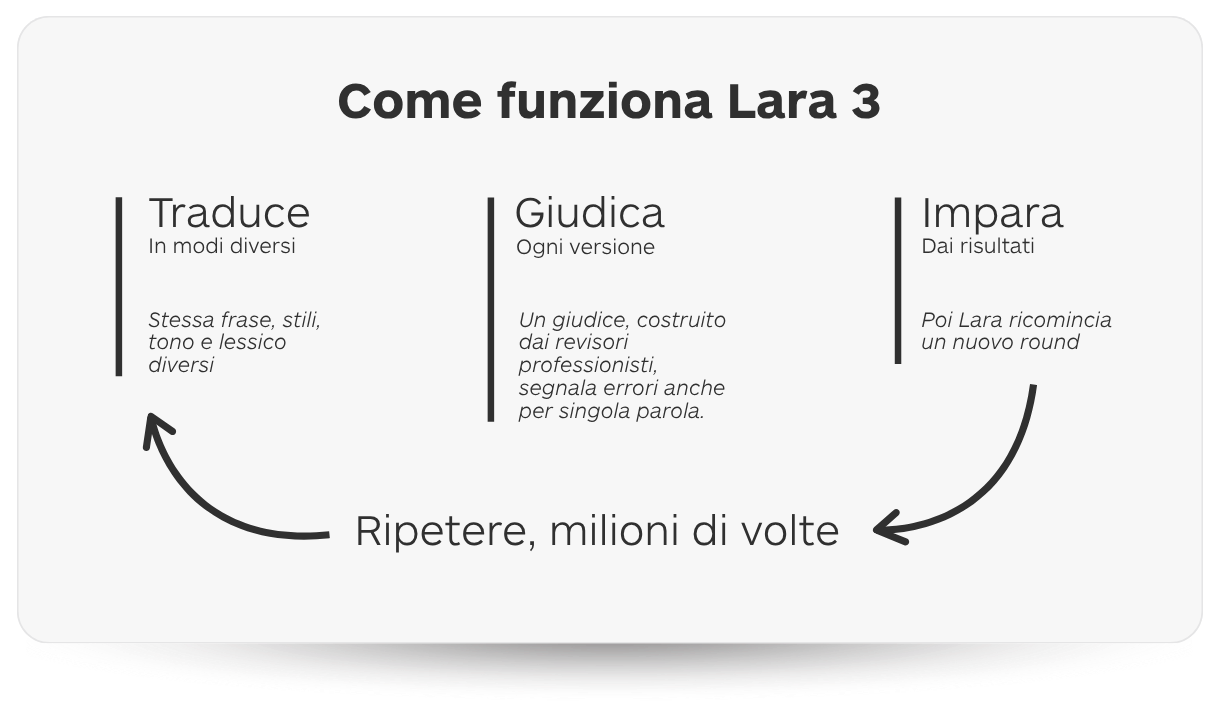
Con Lara 3 è stata introdotta anche una fase di addestramento. Il modello genera traduzioni alternative, un giudice automatico le valuta e il modello si perfeziona nel corso di milioni di cicli. Secondo Translated, Lara Think “riduce gli errori di quasi la metà quando serve una qualità più alta”.
Il rovescio della medaglia è il tempo. Lara Think può impiegare fino a 10 volte più tempo di Lara Base. Se sei uno sviluppatore, un callback può restituire prima una traduzione preliminare veloce, mentre la versione ragionata viene completata.
Che tipo di errori rileva il benchmark?
Questi elementi provengono dal set di valutazione LTBv1. Ognuno mostra cosa significa il testo di partenza e cosa ha prodotto un modello di frontiera.
Esempi da LTBv1-eval con l’output di Gemini 3.1 Pro.
| Fenomeno | Coppia | Testo di partenza | Cosa significa | Output del modello |
|---|---|---|---|---|
| Convenzione culturale | DE→EN | “ein Pfund Mehl” | 500 g di farina | “a pound of flour” |
| Riferimento culturale | EL→EN | “υποβρύχιο βανίλια” | un dolce greco al cucchiaio alla vaniglia | “a vanilla submarine” |
| Espressione politica | FR→EN | “la petite phrase de Sarkozy” | una frecciatina rivolta a un rivale | “Sarkozy’s little phrase” |
| Lacuna grammaticale | ES→EN | “ni tampoco aquel” | “nor that one over there” (né quello laggiù) | “or that one either” |
Nessuno di questi output è sgrammaticato. Ognuno supera una lettura veloce, e ognuno cambia il significato. In ambito professionale è il tipo di errore più costoso: nessuno lo segnala finché non lo fa un cliente, un lettore o un tribunale.
Per chi è Lara Think?
Scegli Lara Think quando una sfumatura sbagliata ti costa più di qualche secondo in più:
- Testi di marketing e di brand, dove tono e giochi di parole veicolano il messaggio
- Se gestisci contenuti legali, finanziari o regolamentati, un solo termine può cambiare un obbligo
- Editoria e lavoro redazionale con dialoghi e registri informali
- Recensioni, post social e altri contenuti generati dagli utenti, pieni di slang
- Stai costruendo una pipeline di localizzazione in cui la qualità è critica? Questo è il modello giusto.
Per chat in tempo reale, volumi molto elevati o flussi di lavoro sensibili alla latenza, Lara Base è la scelta migliore. Lì la velocità conta più degli ultimi casi difficili.
Come provare Lara Think
Gli sviluppatori attivano Lara Think tramite l’API di Lara Translate passando reasoning: true nell’oggetto options. La documentazione per sviluppatori copre SDK, callback e prezzi.
Metti alla prova Lara Think con i tuoi contenuti più difficili
Basta un’opzione dell’API per attivare il ragionamento. Scopri come Lara gestisce gli errori che un output apparentemente fluido di solito nasconde.
In sintesi
I benchmark costruiti con frasi semplici non riescono più a distinguere tra loro i sistemi di traduzione più forti. Il Last Translation Benchmark ci riesce, perché ogni elemento è una trappola. In questo test, Lara 3 Think è in vantaggio di quasi 11 punti, e il merito è della fase di ragionamento. Usalo quando una sfumatura persa costa cara, e tieni Lara Base per la velocità.
Hai uno strumento, una risorsa o un’idea che potrebbe arricchire uno dei nostri articoli?
Scrivici a press@laratranslate.com
Saremo felici di valutarla e di considerarla per arricchire i nostri contenuti per i lettori! ✍️
FAQ
Cos’è il Last Translation Benchmark?
Il Last Translation Benchmark è un test accademico sulla traduzione con l’IA, costruito con esempi scritti da persone che la maggior parte dei principali sistemi di traduzione automatica sbaglia. La prima versione, LTBv1, contiene 3.456 esempi in 109 lingue, inviati da 260 contributori di 177 istituzioni.
Quale traduttore IA ha ottenuto il punteggio più alto nel Last Translation Benchmark?
Lara 3 Think, il modello di ragionamento di Lara Translate, ha ottenuto il punteggio più alto con un tasso di superamento del 56,09% sul set LTBv1-eval di 911 elementi in modalità Blind, al 20 ottobre 2026. GPT-6 Astra Pro è secondo con il 45,33%.
Come viene valutato il Last Translation Benchmark?
Un verificatore LLM confronta ogni traduzione con le regole di superamento scritte dal contributore, e una traduzione passa solo se le rispetta tutte. La classifica live usa Gemini 3.8 Flash come verificatore.
Cos’è Lara Think?
Lara Think è il modello di ragionamento di Lara Translate. Prima di tradurre, analizza il testo di partenza in più fasi, e questo migliora l’accuratezza su contenuti ambigui, informali e legati alla cultura.
Qual è la differenza tra Lara Think e Lara Base?
Lara Base è il modello predefinito, ottimizzato per velocità e coerenza sui contenuti professionali. Lara Think aggiunge un livello di ragionamento per una qualità superiore e può richiedere fino a 10 volte più tempo.
Quanto costa Lara Think?
Lara Think costa 2.000 € per milione di caratteri di testo sorgente con il piano Pro e 1.500 € con il piano Team, tramite l’API di Lara Translate. Non è disponibile con il piano Free.
Di cosa parla questo articolo
- Lara 3 Think si piazza al primo posto nel Last Translation Benchmark con il 56,09%, quasi 11 punti sopra GPT-6 Astra Pro.
- Come è costruito il benchmark: 3.456 esempi su cui i principali traduttori IA hanno sbagliato, da 260 contributori in 109 lingue.
- Perché i risultati vengono valutati da un verificatore LLM con regole scritte dai contributori, e chi finanzia la piattaforma.
- Perché è il ragionamento, e non il semplice addestramento alla traduzione, a decidere le prestazioni su slang, modi di dire e riferimenti culturali.
- Quando scegliere Lara Think invece di Lara Base, e quanto costa tramite l’API.
Fonti
- Last Translation Benchmark: classifica
- Paper del Last Translation Benchmark (arXiv 2609.04173)
- Dataset LTBv1 su Hugging Face
- Introducing Lara 3 (Translated)
- Translate Text: documentazione per sviluppatori di Lara Translate