

L’OCR, o riconoscimento ottico dei caratteri, individua il testo nelle immagini e trasforma le parole di una pagina scansionata in testo digitale accessibile, che persone e software possono cercare, copiare, modificare, archiviare o elaborare.
Questa capacità ti torna utile ogni volta che le informazioni sono “intrappolate” in un’immagine o in una scansione. Può aiutarti a digitalizzare documenti cartacei, estrarre dati da fatture e moduli, rendere ricercabili i PDF scansionati e preparare il testo contenuto nelle immagini per ulteriori elaborazioni. Uno degli utilizzi è la traduzione: una volta che l’OCR ha riconosciuto ed estratto il testo di partenza, un sistema di traduzione può tradurlo in un’altra lingua.
In questa guida scoprirai come funziona l’OCR, quali sono i diversi tipi di OCR, i suoi usi e vantaggi più comuni e cosa può influire sulla precisione del riconoscimento. Ti spiegheremo anche in cosa l’OCR si distingue dall’AI e come lavora insieme alla tecnologia di traduzione per tradurre il testo presente in immagini e documenti.
|
TL;DR
|
Cos’è l’OCR (Optical Character Recognition)?
L’OCR è la parte di un flusso di lavoro di elaborazione di documenti o immagini dedicata al riconoscimento del testo. “Ottico” (optical) si riferisce all’input visivo. “Riconoscimento dei caratteri” (character recognition) significa identificare i simboli scritti, come lettere, numeri e punteggiatura.
La differenza sta tra l’immagine di una parola e la parola memorizzata come testo. L’immagine con la scritta “Fattura 204” per te è leggibile; il testo riconosciuto, invece, permette al software di cercare quel numero di fattura. Il software OCR può funzionare in un’applicazione desktop, in un’app per dispositivi mobili o in un servizio online.
Cosa riesce a leggere l’OCR
A seconda del sistema e delle lingue che supporta, l’OCR può riconoscere il testo in:
- Documenti scansionati e PDF composti solo da immagini
- Foto e screenshot
- Scontrini e fatture
- Moduli ed etichette stampate
- Alcuni documenti scritti a mano
La scrittura a mano richiede funzionalità di riconoscimento adeguate. Il fatto che uno strumento supporti il testo stampato non significa che sappia leggere in modo affidabile la scrittura corsiva.
Come funziona l’OCR?
Un tipico flusso di lavoro OCR si compone di quattro fasi. L’implementazione varia da strumento a strumento, ma queste fasi spiegano come il testo visivo diventa un dato utilizzabile.
1. Acquisizione dell’immagine
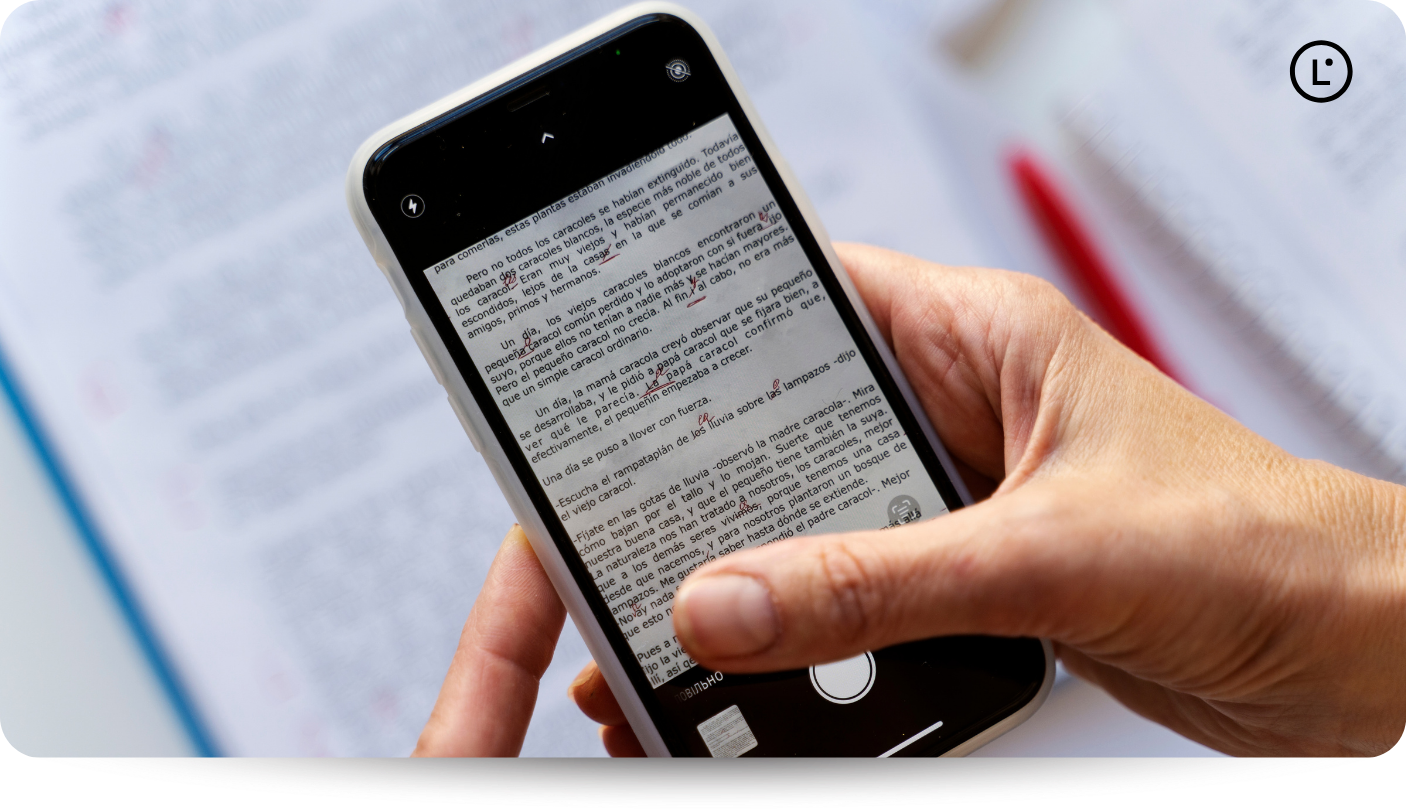
Il sistema riceve un’immagine da uno scanner, da una fotocamera, da uno screenshot o da una pagina PDF. Quando si parla di scansione OCR, di solito si intende scansionare un documento cartaceo e poi applicare l’OCR per riconoscere il testo. Lo scanner acquisisce la pagina come immagine, mentre il software OCR individua il testo all’interno di quell’immagine.
2. Pre-elaborazione dell’immagine
Prima di riconoscere il testo, il software OCR può preparare l’immagine per rendere i caratteri più facili da individuare. Ad esempio raddrizzando una pagina inclinata, eliminando rumore o macchioline, migliorando il contrasto e separando il testo dallo sfondo.
Il sistema può anche analizzare il layout della pagina per individuare colonne, blocchi di testo e altre aree prima che inizi il riconoscimento.
3. Riconoscimento del testo
A questo punto il sistema OCR riconosce i caratteri o le sequenze di testo nell’immagine preparata. I metodi OCR tradizionali possono confrontare la forma dei caratteri con modelli memorizzati oppure analizzare elementi come linee, curve, intersezioni e anelli.
I sistemi OCR moderni possono usare anche il machine learning e le reti neurali per riconoscere caratteri, parole o sequenze di testo. Il metodo esatto dipende dalla tecnologia OCR utilizzata.
4. Post-elaborazione
Dopo il riconoscimento, il sistema converte i caratteri rilevati in testo utilizzabile e leggibile dalla macchina. A seconda dello strumento OCR, la post-elaborazione può correggere la spaziatura, sfruttare informazioni linguistiche per migliorare il riconoscimento, ricostruire parole e righe o creare un livello di testo ricercabile in un PDF.
L’OCR non è sempre perfetto, quindi potresti dover controllare il risultato quando i caratteri si assomigliano, l’immagine di partenza non è nitida o il documento ha un layout complesso.
Se il flusso di lavoro prevede la traduzione, il testo di partenza riconosciuto può poi passare a un sistema di traduzione, che lo traduce nella lingua di destinazione scelta.
Quali sono i diversi tipi di OCR?
Le spiegazioni più diffuse raggruppano diversi metodi di riconoscimento. La terminologia varia, e il riconoscimento ottico dei segni (OMR) è una tecnologia affine per l’elaborazione dei moduli, più che un riconoscimento dei caratteri in senso stretto.
1. OCR semplice
L’OCR semplice confronta i caratteri stampati con modelli noti. Funziona meglio quando il testo di partenza assomiglia ai font e alle forme dei caratteri che il sistema si aspetta. Caratteri insoliti possono rendere più difficile il confronto.
2. Intelligent Character Recognition (ICR)
L’ICR utilizza metodi di riconoscimento basati sull’apprendimento e viene spesso impiegato per leggere caratteri scritti a mano. Le sue capacità dipendono dal modello e dalla scrittura che è stato addestrato a riconoscere. Il nome non garantisce un riconoscimento affidabile di qualsiasi stile di scrittura a mano.
3. Intelligent Word Recognition (IWR)
L’IWR analizza l’immagine di una parola intera, invece di identificare ogni carattere separatamente. È una distinzione utile, anche se nella pratica i prodotti OCR possono combinare più metodi.
4. Optical Mark Recognition (OMR)
L’OMR rileva caselle annerite, spunte o altri segni in campi predefiniti. Un esempio familiare è il foglio risposte di un test a crocette. Stabilisce se un’opzione è stata selezionata, ma non trascrive una risposta scritta. ABBYY descrive l’OMR proprio come riconoscimento dei segni di spunta.
Perché l’OCR è importante?
L’OCR è importante perché un documento può essere digitale senza che il testo al suo interno sia utilizzabile come testo digitale. Per esempio, quando scansioni una fattura cartacea e la salvi come immagine o come PDF basato su immagini, vedi le parole sullo schermo, ma il software potrebbe comunque trattare la pagina come un’immagine, non come testo ricercabile o modificabile.
Il riconoscimento ottico dei caratteri risolve il problema identificando il testo nell’immagine e convertendolo in dati leggibili dalla macchina. Una volta riconosciuto, il testo si può cercare, copiare, modificare, analizzare, salvare in un database o passare ad altri software per ulteriori elaborazioni. Ecco perché l’OCR è così diffuso per portare le informazioni di documenti cartacei, file scansionati, scontrini, moduli e altre fonti visive all’interno dei flussi di lavoro digitali.
Il valore dell’OCR diventa più chiaro se guardi a cosa rende possibile quel testo leggibile dalla macchina.
Quali sono i vantaggi dell’OCR?
Il vantaggio principale dell’OCR è che rende utilizzabile, da persone e software, il testo “intrappolato” nelle immagini e nei documenti scansionati. A seconda del sistema OCR e della qualità del documento di partenza, questo può ridurre il lavoro ripetitivo e rendere le informazioni dei documenti più facili da trovare ed elaborare.
Rende i documenti ricercabili
Un documento scansionato può sembrare un normale PDF, mentre in realtà ogni pagina è memorizzata come immagine. In questo caso, cercare il nome di una persona, un numero di fattura o una frase potrebbe non funzionare, perché il file non contiene testo ricercabile.
L’OCR riconosce le parole su quelle pagine e può aggiungere testo leggibile dalla macchina, rendendo il documento ricercabile. Ad esempio, invece di controllare a mano centinaia di fatture scansionate, un dipendente può cercare nell’archivio digitalizzato il nome di un cliente o un numero di riferimento. AWS indica gli archivi di documenti ricercabili tra i principali vantaggi dell’OCR.
Riduce l’inserimento manuale dei dati
Senza l’OCR, qualcuno potrebbe dover leggere le informazioni da uno scontrino, un modulo di richiesta o una fattura e digitarle a mano in un altro sistema.
L’OCR può riconoscere quel testo in automatico, così da poterlo usare in un flusso di lavoro digitale. I sistemi di elaborazione documentale più avanzati riescono anche a individuare campi come nomi, date, numeri di fattura o importi e a inviare le informazioni estratte a database o applicazioni aziendali.
Questo non significa che l’OCR elimini la necessità di verifiche. Le informazioni importanti possono comunque richiedere un controllo umano, soprattutto quando il documento originale è sfocato, danneggiato, scritto a mano o formattato in modo insolito.
Rende il testo modificabile
L’OCR può trasformare il testo contenuto in un’immagine in testo che puoi selezionare e modificare. Per esempio, se hai solo la copia scansionata di un vecchio report, l’OCR può riconoscerne il contenuto senza costringerti a ribattere l’intero documento.
Supporta l’automazione dei flussi di lavoro
Una volta che l’OCR ha convertito le informazioni in testo leggibile dalla macchina, software di contabilità, sistemi di gestione documentale, database e altre applicazioni possono usare quei dati in flussi di lavoro automatizzati.
Ad esempio, un’azienda potrebbe ricevere una fattura, usare l’OCR per estrarne il contenuto e poi passare le informazioni rilevanti a un flusso di contabilità o di elaborazione documentale. Spesso, quindi, l’OCR è un tassello di un processo di automazione più ampio, non il sistema che gestisce l’intero flusso.
Migliora l’accesso ai contenuti scansionati
L’OCR può rendere selezionabile e ricercabile il testo dei documenti scansionati: un passo importante per rendere più accessibili e lavorabili informazioni che prima esistevano solo come immagini.
L’OCR può anche supportare i flussi di lavoro per l’accessibilità, perché le tecnologie assistive hanno bisogno di accedere al testo vero e proprio, non solo ai pixel.
Abilita l’elaborazione AI a valle
In genere, i sistemi di AI hanno bisogno di dati utilizzabili per analizzare il contenuto dei documenti. Se informazioni importanti esistono solo come pixel all’interno di una scansione, l’OCR può prima convertire quel testo visivo in contenuto leggibile dalla macchina.
A quel punto puoi usare il testo estratto in attività successive come classificazione dei documenti, creazione di riassunti, riconoscimento delle entità, ricerca o altri flussi di elaborazione del linguaggio naturale. In questo ruolo, l’OCR fa da livello di estrazione del testo, senza svolgere da solo tutte quelle attività di AI.
Rende possibile la traduzione di immagini e documenti scansionati
L’OCR ti è utile anche quando il testo che vuoi tradurre si trova all’interno di un’immagine o di un documento scansionato.
Quando devi tradurre un testo visivo, l’OCR lo rende prima leggibile dalla macchina, così che un sistema di traduzione possa elaborarlo. L’OCR quindi supporta la traduzione, ma non la esegue. Si occupa del riconoscimento, mentre la tecnologia di traduzione gestisce il lavoro linguistico di convertire il contenuto in un’altra lingua.
A cosa serve l’OCR?
L’OCR si usa ogni volta che informazioni utili sono bloccate in un’immagine, in una scansione o in un documento cartaceo e devono diventare testo digitale. Una volta che l’OCR ha identificato quel testo, persone e software possono cercarlo, copiarlo, modificarlo, estrarne informazioni specifiche o inviarlo a un altro sistema per ulteriori elaborazioni.
Ecco alcuni degli usi più comuni dell’OCR nei flussi di lavoro quotidiani e aziendali.
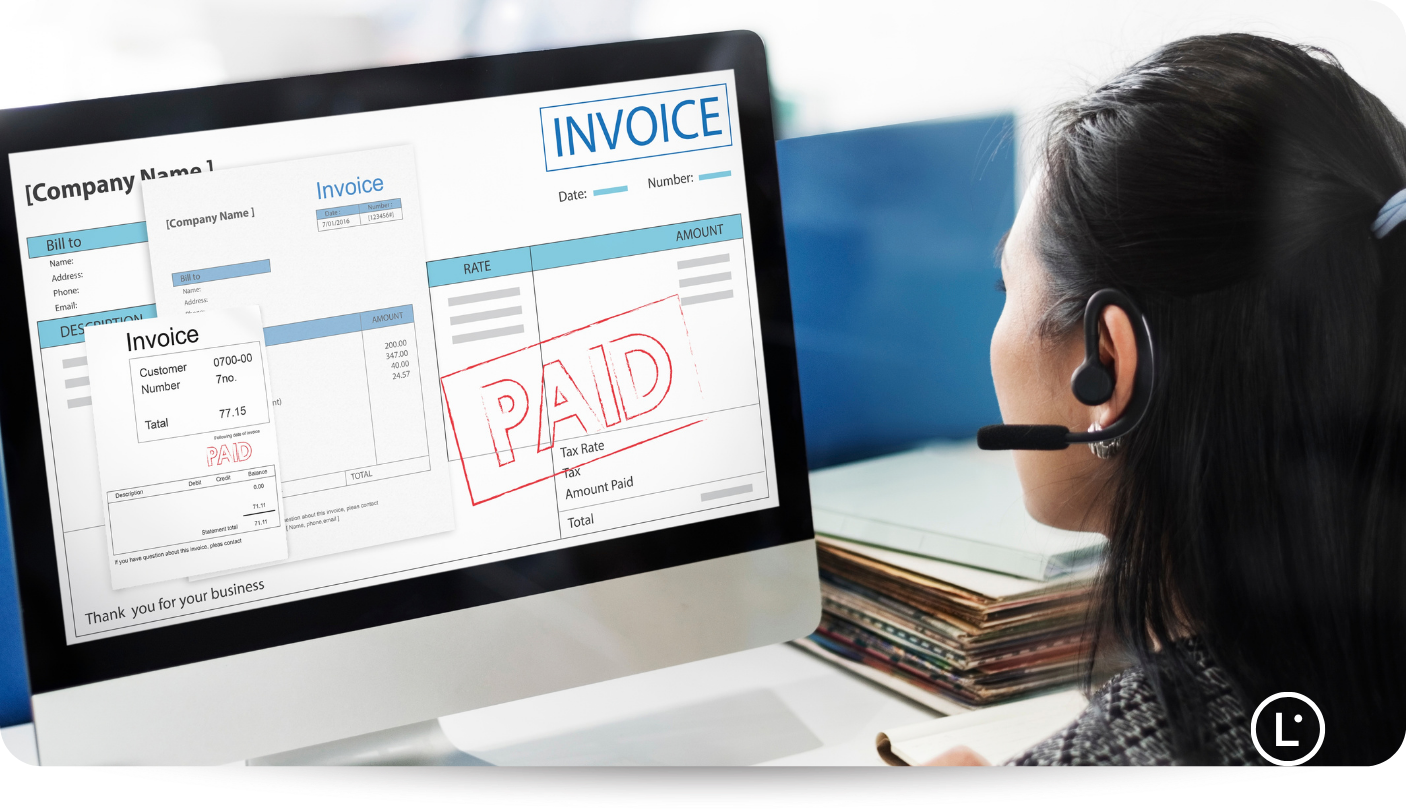
Scansionare scontrini e fatture
Scontrini e fatture contengono spesso informazioni che altrimenti qualcuno dovrebbe inserire a mano, come numeri di fattura, date, nomi dei fornitori, totali e importi delle imposte.
L’OCR può riconoscere queste informazioni da un documento scansionato o fotografato e convertirle in testo digitale. I sistemi di elaborazione documentale più avanzati possono poi individuare campi specifici e inviare i dati pertinenti a software di contabilità, di gestione delle note spese o ad altri programmi aziendali.
Ad esempio, invece di digitare a mano il totale di ogni scontrino dei dipendenti in un sistema di note spese, l’OCR può fornire il testo di cui il sistema ha bisogno.
Digitalizzare libri e documenti storici
Biblioteche, archivi, ricercatori ed editori possono usare l’OCR per rendere più facile esplorare in digitale vecchio materiale stampato.
Scansionare un giornale o un libro conserva un’immagine della pagina originale, ma l’OCR aggiunge un ulteriore livello utile, convertendo i caratteri stampati in testo leggibile dal computer. A quel punto puoi cercare in quel testo nomi, date, frasi e altre informazioni.
Rendere ricercabili i PDF scansionati
Quando scansioni un documento cartaceo in PDF, all’inizio le pagine ottenute potrebbero contenere solo dati immagine. Vedi le parole, ma potresti non riuscire a selezionarle o a cercare una frase specifica nel PDF.
L’OCR riconosce il testo nelle immagini di quelle pagine e può aggiungere al PDF un livello di testo ricercabile. Così, chi lavora con un lungo report, un contratto o un archivio scansionato può cercare un nome o un termine invece di leggere ogni pagina a mano.
Questa è anche la risposta pratica alla domanda cos’è l’OCR in un PDF: è il processo di riconoscimento che rende disponibile come testo leggibile dalla macchina un testo memorizzato come immagine.
Estrarre dati dai moduli
I moduli sono un altro caso d’uso comune dell’OCR, perché contengono spesso informazioni da trasferire in un sistema digitale.
L’OCR può riconoscere il testo stampato o scansionato in domande, moduli di registrazione, questionari e altri documenti. A seconda del sistema di elaborazione documentale, il contenuto riconosciuto può poi essere revisionato, classificato o inserito in un altro flusso di lavoro, senza che qualcuno debba ribattere l’intero modulo.
I moduli compilati a mano possono essere più difficili da elaborare con precisione rispetto a un testo stampato pulito, quindi le informazioni importanti potrebbero comunque richiedere una verifica umana.
Riconoscere il testo su documenti d’identità e passaporti
Le organizzazioni possono usare l’OCR per estrarre il testo da documenti d’identità come passaporti, patenti di guida e carte d’identità. Ad esempio nomi, numeri di documento e date.
I dati estratti possono poi supportare flussi di lavoro come l’onboarding dei clienti, l’elaborazione dei documenti d’identità o i controlli di conformità. L’OCR, di per sé, riconosce solo il testo. Non dimostra che un documento d’identità sia autentico né che la persona che lo presenta ne sia la legittima titolare. Per queste verifiche servono sistemi e processi aggiuntivi.
Migliorare l’accessibilità e la sintesi vocale
Un testo contenuto solo in un’immagine scansionata può essere difficile da usare per le tecnologie assistive, perché potrebbe mancare un testo digitale sottostante da leggere.
L’OCR può convertire quel testo in testo vero e proprio, rendendolo disponibile per ulteriori interventi di accessibilità e per tecnologie come la sintesi vocale (text-to-speech).
Tuttavia, l’OCR da solo non rende un documento pienamente accessibile. Un PDF potrebbe comunque aver bisogno di titoli corretti, tag, ordine di lettura, testo alternativo e altre funzionalità di accessibilità.
Tradurre immagini e documenti scansionati
L’OCR ti permette anche di tradurre testo che non è già disponibile come contenuto digitale modificabile.
Immagina di ricevere uno screenshot con delle istruzioni in tedesco. Un sistema di traduzione non può semplicemente trattare le lettere visibili come normale testo digitato. Prima l’OCR rileva ed estrae il testo tedesco dall’immagine. Poi quel testo riconosciuto può passare a un sistema di traduzione, che lo traduce nella lingua di destinazione.
OCR e traduzione svolgono quindi compiti diversi. L’OCR rende il testo leggibile dalla macchina, il sistema di traduzione si occupa della conversione linguistica.
Questa combinazione è particolarmente utile quando il testo da tradurre non si può copiare e incollare, perché si trova in uno screenshot, in una scansione, in una foto o in un documento basato su immagini.
In che modo l’OCR supporta la traduzione?
L’OCR supporta la traduzione trasformando il testo visivo in dati linguistici. In un flusso di lavoro basato sull’OCR, il riconoscimento produce il testo nella lingua di partenza e il sistema di traduzione produce poi il testo nella lingua di arrivo. Uno strumento image-to-image aggiunge un ulteriore passaggio, reinserendo la traduzione nell’immagine.
Vediamolo con un esempio.
Immagina di caricare la foto di un menu giapponese in uno strumento di traduzione di immagini:
- L’OCR individua e riconosce la scrittura giapponese.
- Il sistema rende disponibili come testo le voci del menu riconosciute.
- Uno strumento di traduzione genera il testo in italiano.
- Se è supportato l’output image-to-image, il software inserisce quel testo nell’immagine del menu.
- Prima di usare il risultato, controlli nomi dei piatti, descrizioni e prezzi.
Se l’OCR legge male un prezzo o salta una riga, la fase di traduzione riceve informazioni di partenza incomplete o sbagliate. Una traduzione scorrevole, da sola, non dimostra che il sistema abbia riconosciuto correttamente tutto ciò che c’è nell’immagine.
Come si usa l’OCR nella traduzione di immagini e documenti?
Quando il testo che vuoi tradurre fa parte di un’immagine e non è selezionabile, il sistema di traduzione deve prima trovare un modo per accedere a quelle parole. L’OCR fa questo primo passo: riconosce il testo a partire dai pixel e lo converte in testo leggibile dalla macchina.
Cosa succede dopo dipende dal risultato che ti serve. Magari vuoi solo le parole tradotte, oppure ti serve il testo tradotto reinserito nell’immagine o nel documento originale.
Traduzione image-to-text
La traduzione del testo in un’immagine è utile quando devi capire o riutilizzare le parole di un’immagine, ma non hai bisogno di conservarne l’aspetto originale.
Per esempio, ricevi la foto delle specifiche di un prodotto scritte in tedesco. Prima l’OCR riconosce il testo tedesco nella foto. Poi il testo estratto può essere tradotto in italiano e copiato in un documento, un’email, un foglio di calcolo o un’altra applicazione.
Questo approccio funziona bene per screenshot, cartelli, menu, paragrafi scansionati, informazioni di prodotto e altri contenuti in cui il significato conta più dell’aspetto dell’immagine originale.
Traduzione image-to-image
A volte estrarre il testo non basta, perché l’immagine stessa deve restare utilizzabile.
Immagina un team che ha lo screenshot di un’interfaccia in spagnolo e deve condividerlo con colleghi italiani. Ricevere il testo italiano come paragrafo separato lo staccherebbe da pulsanti, etichette e altri elementi visivi che gli danno contesto.
La traduzione image-to-image aggiunge un passaggio:
Immagine → l’OCR estrae il testo → il sistema di traduzione lo traduce → il testo tradotto viene reinserito nell’immagine.
Con il flusso di traduzione di immagini di Lara Translate, l’OCR estrae il testo, Lara Translate lo traduce nella lingua di destinazione scelta e l’immagine viene ricostruita con il testo tradotto. Il risultato ti viene restituito nello stesso formato dell’immagine originale, mantenendo il più possibile posizione e layout originali.
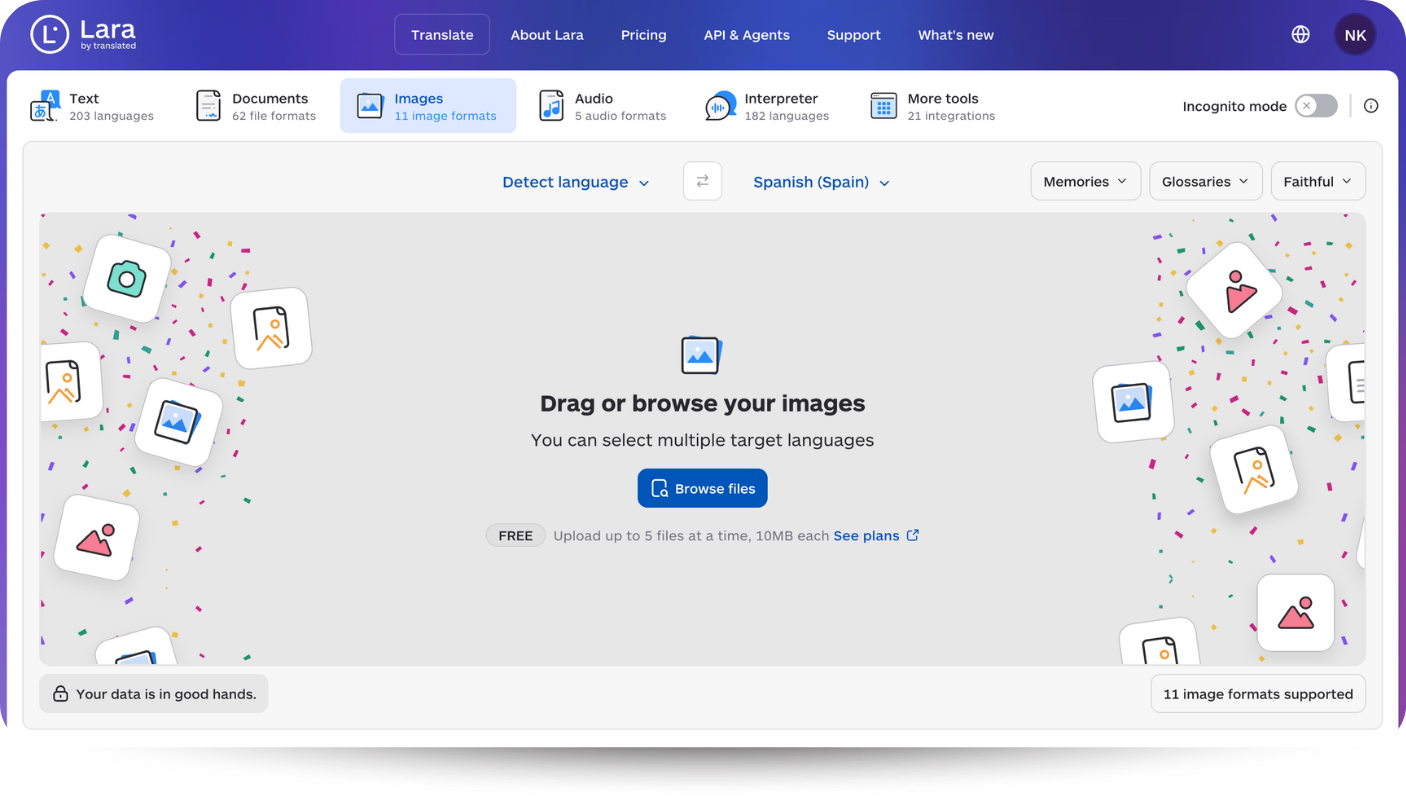
Per questo la traduzione image-to-image è più utile quando devi condividere, revisionare o mantenere l’immagine in un flusso di lavoro: screenshot, grafiche, immagini scansionate, etichette o istruzioni visive.
Se devi scegliere tra i due approcci, la guida di Lara Translate su image-to-image ed estrazione del testo con OCR offre una regola pratica: scegli image-to-text quando ti serve solo il contenuto, e image-to-image quando ti serve una risorsa tradotta pronta da usare.
Traduci il testo nelle immagini con Lara Translate
Devi tradurre uno screenshot, una scansione, un’etichetta o un’altra immagine? Lara Translate riconosce il testo, lo traduce e ti restituisce un’immagine tradotta, senza doverla ricostruire a mano.
Traduzione di PDF scansionati
I PDF possono contenere più di un tipo di testo. Alcuni contengono testo digitale selezionabile, altri pagine scansionate o immagini in cui le parole esistono solo come pixel.
Questa distinzione spiega cos’è l’OCR in un PDF. Quando il testo esiste solo all’interno di una pagina scansionata o di un’immagine incorporata, l’OCR lo rileva e lo converte in testo leggibile dalla macchina, così da poterlo elaborare. A seconda del flusso di traduzione, puoi poi reinserire il contenuto tradotto nel documento.
Cosa può influire sull’accuratezza dell’OCR?
L’OCR funziona al meglio quando i caratteri di un’immagine sono nitidi e facili da distinguere per il sistema di riconoscimento. Quando le lettere sono sfocate, piccolissime, inclinate o su uno sfondo complesso, l’OCR dispone di informazioni visive meno affidabili.
Conta anche il motore OCR, quindi non esiste un unico livello di accuratezza valido per tutti gli strumenti o tutti i documenti.
Diversi fattori possono rendere il riconoscimento più difficile.
Bassa risoluzione e sfocatura
Le immagini a bassa risoluzione contengono meno dettagli, e questo può rendere difficile distinguere caratteri simili. La sfocatura crea un problema analogo, perché i contorni delle lettere diventano meno definiti.
Per esempio, un 8 sfocato può essere scambiato per un 3, oppure una O per uno 0. È un aspetto particolarmente importante quando il testo contiene prezzi, misure, codici prodotto o date.
Poca luce e basso contrasto
L’OCR deve distinguere i caratteri dallo sfondo. Una foto scura, un’illuminazione irregolare, riflessi, ombre o un testo poco contrastato rispetto allo sfondo possono rendere quei confini meno evidenti.
Per esempio, un testo grigio chiaro su uno sfondo grigio con motivi può essere perfettamente comprensibile per una persona, ma più difficile da separare con precisione per un software OCR.
Usare un’immagine più nitida e con un contrasto più marcato può migliorare la fase di riconoscimento, prima ancora che inizi la traduzione.
Testo inclinato, ruotato o curvo
Una pagina scansionata leggermente storta può influire sul modo in cui il sistema OCR individua righe di testo e caratteri. Il testo ruotato o curvo può essere ancora più difficile da leggere, soprattutto su confezioni, poster, etichette e pubblicità. Raddrizzare l’immagine prima del riconoscimento può aiutare.
Font decorativi e scrittura a mano
In generale, per l’OCR è più facile lavorare con caratteri stampati chiari e convenzionali che con scritte molto stilizzate.
I font decorativi possono alterare la forma abituale delle lettere, mentre la grafia cambia molto da persona a persona. Una “r” scritta a mano, ad esempio, può essere molto diversa dalla versione stampata che un modello OCR si aspetta.
I sistemi di riconoscimento moderni gestiscono una parte della scrittura a mano, ma i risultati dipendono dalla tecnologia OCR, dallo stile di scrittura e dalla qualità dell’immagine di partenza.
Testo su sfondi complessi
Un testo sovrapposto a fotografie, sfumature, texture, ombre o illustrazioni costringe il sistema OCR a separare una quantità maggiore di informazioni visive.
Una frase nera su una pagina bianca ha confini netti. La stessa frase sopra una foto di prodotto ricca di dettagli può presentare contorni e colori che interferiscono con il riconoscimento dei caratteri.
Testo piccolo
Etichette minuscole, note a piè di pagina, disclaimer e didascalie sfuggono facilmente, soprattutto in screenshot a bassa risoluzione o immagini compresse.
Nella traduzione, questo può essere più di un piccolo inconveniente. Un titolo saltato è una seccatura, ma un’avvertenza, un dosaggio, una misura o un disclaimer mancati possono cambiare il modo in cui viene interpretato il contenuto tradotto.
Quando puoi, usa una fonte a risoluzione più alta oppure ingrandisci l’area interessata prima del riconoscimento.
Colonne multiple e layout complessi
L’OCR non deve solo riconoscere i singoli caratteri. In molti documenti deve anche capire come le diverse aree di testo si collegano tra loro.
Una pagina con più colonne, box di approfondimento, tabelle, didascalie o etichette flottanti può quindi creare problemi di ordine di lettura. Le parole possono essere riconosciute correttamente, ma restituite nella sequenza sbagliata.
Per la traduzione è un dettaglio importante, perché l’ordine delle frasi fornisce il contesto.
Lingue miste e sistemi di scrittura diversi
A volte le immagini contengono più lingue o più sistemi di scrittura. Un’etichetta di prodotto, ad esempio, potrebbe combinare inglese, giapponese e dati numerici nella stessa immagine.
La qualità del riconoscimento dipende in parte dal fatto che il sistema OCR supporti e identifichi correttamente le lingue o gli alfabeti coinvolti.
Documenti di partenza danneggiati o “rumorosi”
Le scansioni più vecchie possono presentare macchie, stampa sbiadita, parti strappate, puntini, annotazioni a mano o segni dovuti a fotocopie ripetute. Questi dettagli possono interferire con le forme che l’OCR cerca di riconoscere.
Le tecniche di pulizia delle immagini, come la rimozione del rumore, la regolazione del contrasto e il ridimensionamento, possono migliorare alcuni materiali di partenza, ma non possono recuperare caratteri che nell’originale non sono più visibili.
Nei flussi di traduzione l’accuratezza dell’OCR merita attenzione, perché un errore in fase di riconoscimento può ripercuotersi sul risultato tradotto. Prima di fidarti del contenuto tradotto di un’immagine, confronta con l’originale nomi, numeri, date, misure, avvertenze e testi in piccolo.
Qual è la storia dell’OCR?
I tentativi di far leggere alle macchine informazioni visive sono iniziati prima dei computer moderni. Nei primi decenni del Novecento alcuni dispositivi sperimentavano il riconoscimento del testo stampato o la conversione dei suoi schemi visivi in segnali. Negli anni ’50 e ’60 sono stati sviluppati sistemi di riconoscimento commerciali per compiti circoscritti, come l’elaborazione dei documenti in ambito bancario e, più tardi, lo smistamento della corrispondenza nei servizi postali.
Una tappa fondamentale è arrivata nel 1976 con la presentazione della Kurzweil Reading Machine. Univa scansione, riconoscimento del testo stampato in diversi caratteri tipografici e sintesi vocale per leggere ad alta voce i documenti alle persone non vedenti. Il resoconto di Kurzweil descrive anche le applicazioni successive nei database e nella videoscrittura.
In seguito l’OCR è entrato a far parte della scansione desktop e della digitalizzazione dei documenti, poi dei servizi mobile e cloud. I sistemi moderni usano sempre più spesso modelli addestrati per gestire le variazioni nell’aspetto e nel layout del testo.
Questa evoluzione spiega perché oggi l’OCR si trova sia come funzione a sé sia come componente di un’applicazione più ampia. Leggere una pagina può servire a molti scopi diversi, tra cui ricerca, sintesi vocale, estrazione di dati e traduzione.
Come usa l’OCR Lara Translate per tradurre immagini e documenti?
Lara Translate usa l’OCR come fase di riconoscimento quando il testo è contenuto in un’immagine invece di essere disponibile come normale testo digitale. Prima l’OCR estrae il testo di partenza dall’immagine. Poi Lara Translate lo traduce nella lingua di destinazione scelta.
La distinzione è importante: l’OCR identifica le parole, Lara Translate ne traduce il significato. Lara Translate unisce questi passaggi nei suoi flussi di traduzione delle immagini, così non devi estrarre il testo a mano, incollarlo in un traduttore e poi ricostruire l’immagine da solo.
Traduci immagini singole
Lara Translate supporta la traduzione image-to-image di screenshot, foto, grafiche, immagini scansionate e altri file visivi singoli. La traduzione delle immagini è disponibile anche nelle app Lara Translate per iOS e Android.
Per esempio, se carichi l’etichetta di un prodotto scritta in tedesco e scegli l’italiano come lingua di destinazione, l’OCR identifica prima il testo tedesco. Lara Translate traduce il contenuto riconosciuto e ti restituisce un’immagine con il testo tradotto, non solo un blocco di parole estratte.
Al momento Lara Translate supporta i formati immagine più comuni, tra cui JPG, JPEG, PNG, WEBP, HEIC, HEIF, TIFF, TIF, AVIF, BMP e GIF.
Traduci il testo nelle immagini dei PDF
Un PDF può contenere sia normale testo selezionabile sia immagini che contengono a loro volta del testo. Per tradurre le parole del secondo tipo serve prima l’OCR.
Lara Translate ti permette di tradurre questo testo all’interno della traduzione di un PDF. Quando un PDF contiene immagini, puoi attivare l’opzione Translate images durante il caricamento. Lara Translate rileva quindi con l’OCR il testo all’interno di quelle immagini e lo traduce insieme al resto del documento.
L’opzione è disattivata di default, quindi devi attivarla quando ti serve. Se resta disattivata, Lara Translate traduce il normale testo del documento ma non quello contenuto nelle immagini. Con Translate images attiva, i caratteri estratti e tradotti da ogni immagine tradotta vengono conteggiati nel tuo utilizzo.
È utile per i PDF che contengono screenshot, diagrammi, sezioni scansionate, etichette di prodotto o altri elementi visivi con testo importante. Se lavori soprattutto con i PDF, puoi anche provare il flusso di traduzione di documenti per tradurre file di ogni tipo.
Mantieni l’aspetto visivo
Estrarre e tradurre il testo è solo una parte del lavoro, se poi devi ancora condividere o usare l’immagine originale.
Con la traduzione di immagini singole, Lara Translate ricostruisce l’immagine con il contenuto tradotto e mantiene il più possibile layout e posizione originali. L’obiettivo è restituirti una risorsa tradotta pronta da usare, invece di un testo tradotto staccato da reinserire a mano.
È un aspetto importante per contenuti come screenshot, menu, cartelli, etichette e grafiche, dove la posizione delle parole aiuta a capire a cosa si riferiscono.
Tuttavia, mantenere il layout non equivale a garantire un risultato visivo identico. Frasi tradotte più lunghe, aree di testo piccole, sfondi complessi ed errori di OCR possono comunque influire sull’immagine finale.
Applica i controlli di traduzione
L’OCR determina quale testo Lara Translate riceve da un’immagine, ma non decide come esprimere in un’altra lingua un nome di prodotto, un termine tecnico o una frase ambigua.
Nei flussi di traduzione di testi e documenti, Lara Translate offre controlli aggiuntivi per questa parte del processo. Lara Translate applica i glossari attivi alle traduzioni di testi e documenti, così i termini approvati restano coerenti.
Anche l’API di traduzione delle immagini di Lara Translate può usare memorie di traduzione e glossari per mantenere la coerenza terminologica e traduttiva. Supporta quattro modalità di output: Overlay, che sovrappone il testo tradotto all’immagine originale; Inpainting, che rimuove il testo di partenza e ricostruisce l’area prima di inserire la traduzione; Generative, che rigenera l’immagine con il contenuto tradotto; Image-to-Text, che restituisce come testo il testo di partenza rilevato e la sua traduzione, invece di un’immagine ricostruita.
Per la traduzione di testi puoi anche fornire contesto su argomento, pubblico, tono o significato inteso di parole ambigue. Per esempio, dire a Lara Translate che una frase viene da un documento medico o da una campagna di marketing dà al sistema di traduzione più informazioni su come interpretare il testo.
Il punto è semplice: l’OCR estrae le parole dall’immagine, Lara Translate gestisce cosa significano quelle parole nella lingua di destinazione. Quando il flusso scelto offre controlli di traduzione aggiuntivi, questi ti aiutano a gestire terminologia e contesto dopo la fase di riconoscimento.
Come tradurre il testo di un’immagine con Lara Translate
Ecco come tradurre il testo di un’immagine con Lara Translate:
Passaggio 1: apri Lara Translate, vai su Images e carica un file immagine supportato.
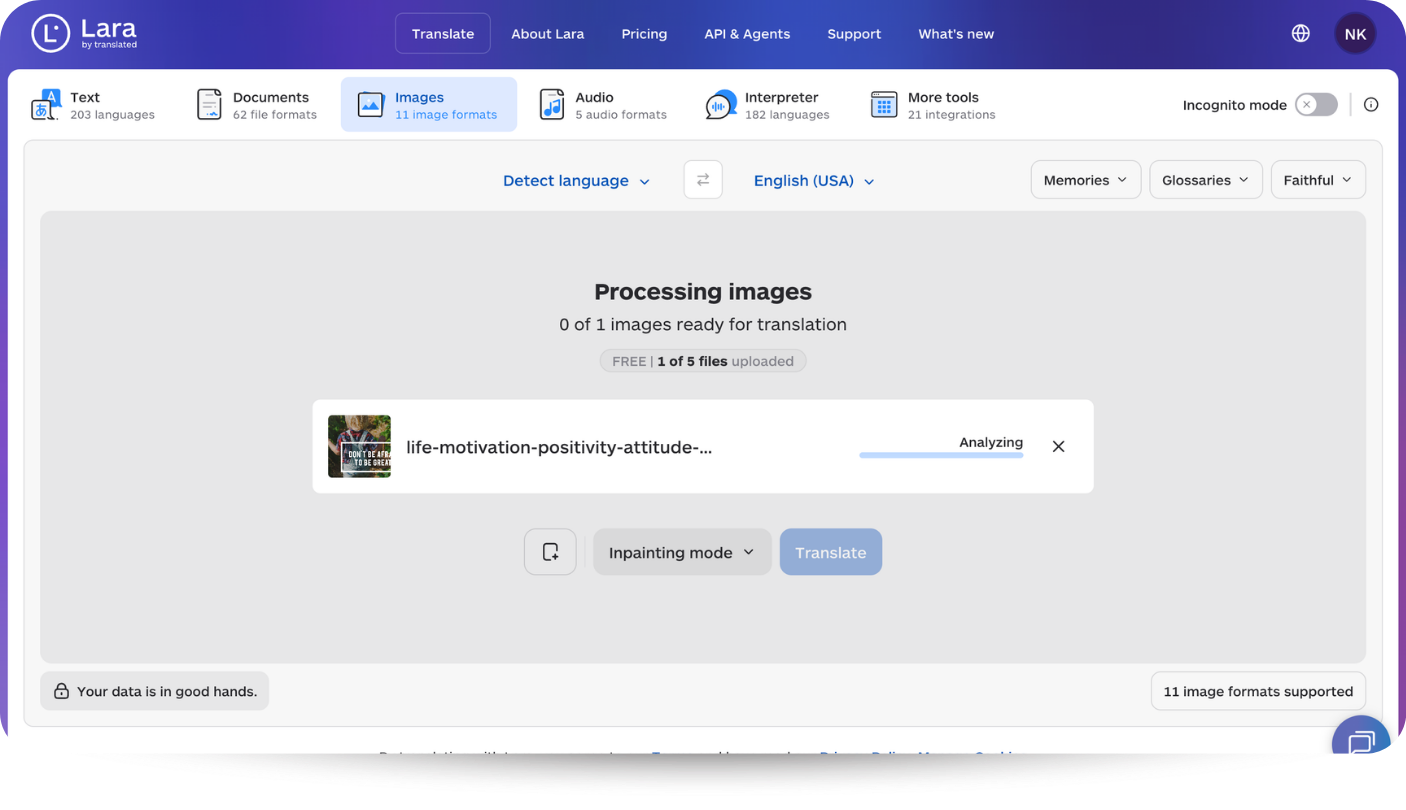
Passaggio 2: controlla la lingua di partenza e scegli una delle lingue di destinazione disponibili.
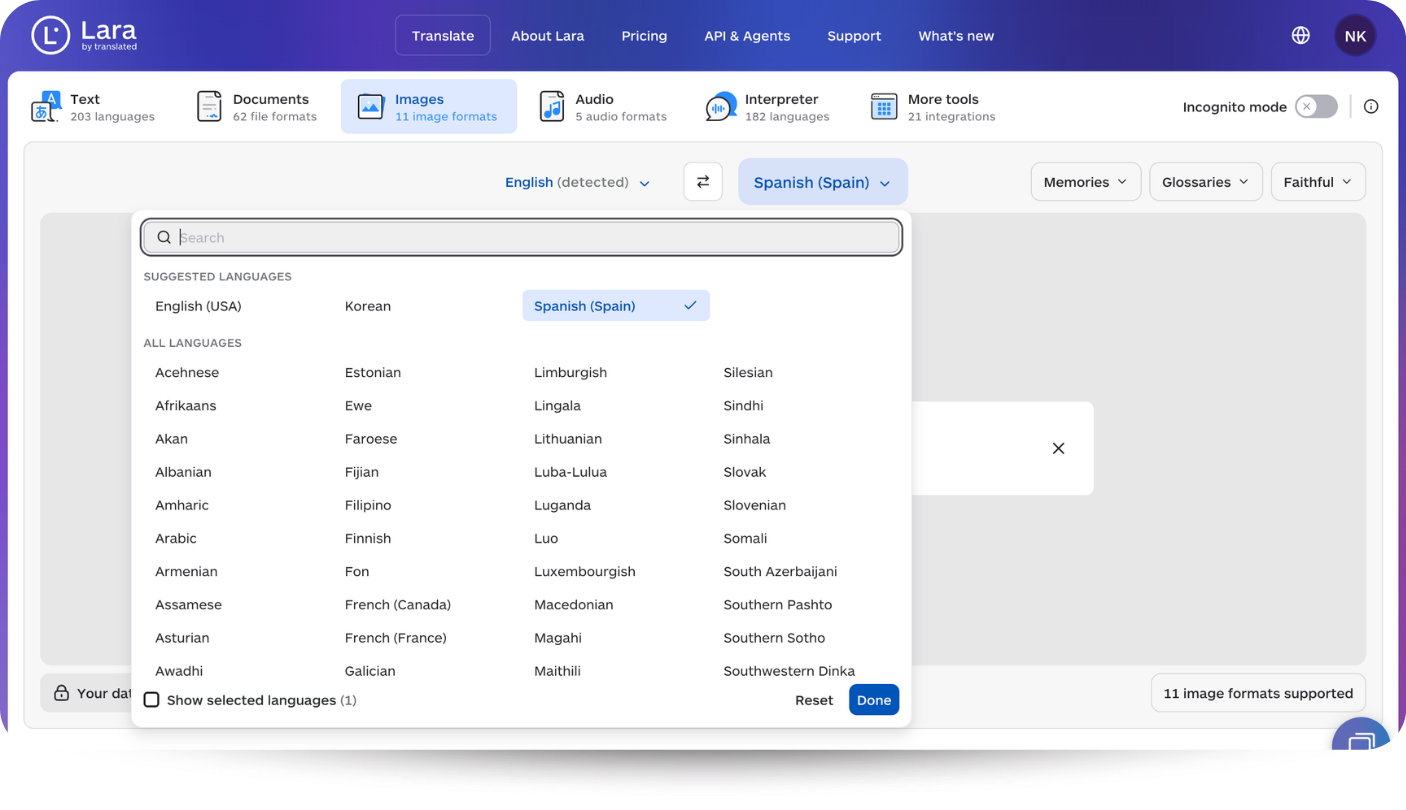
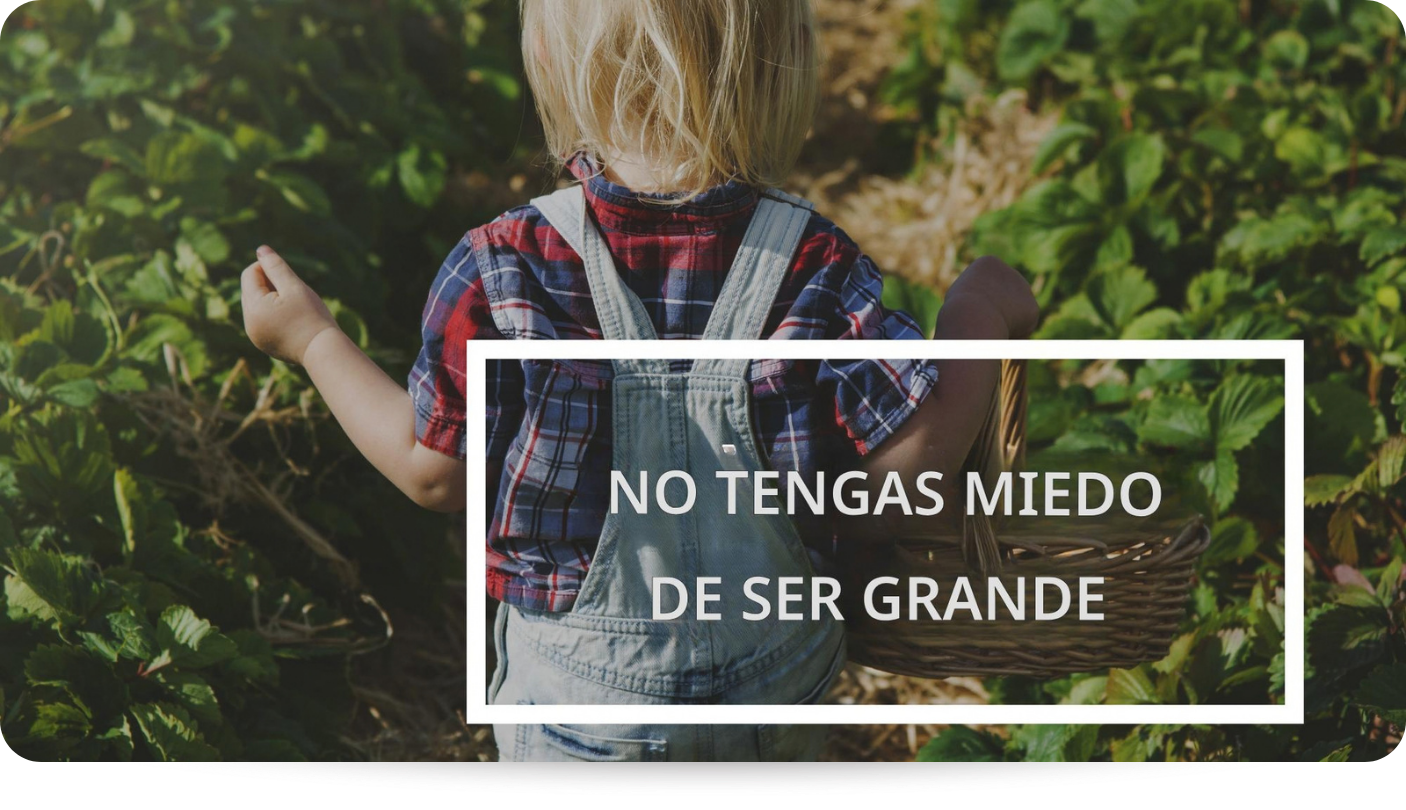
Passaggio 3: avvia la traduzione e scarica l’immagine tradotta quando è pronta.
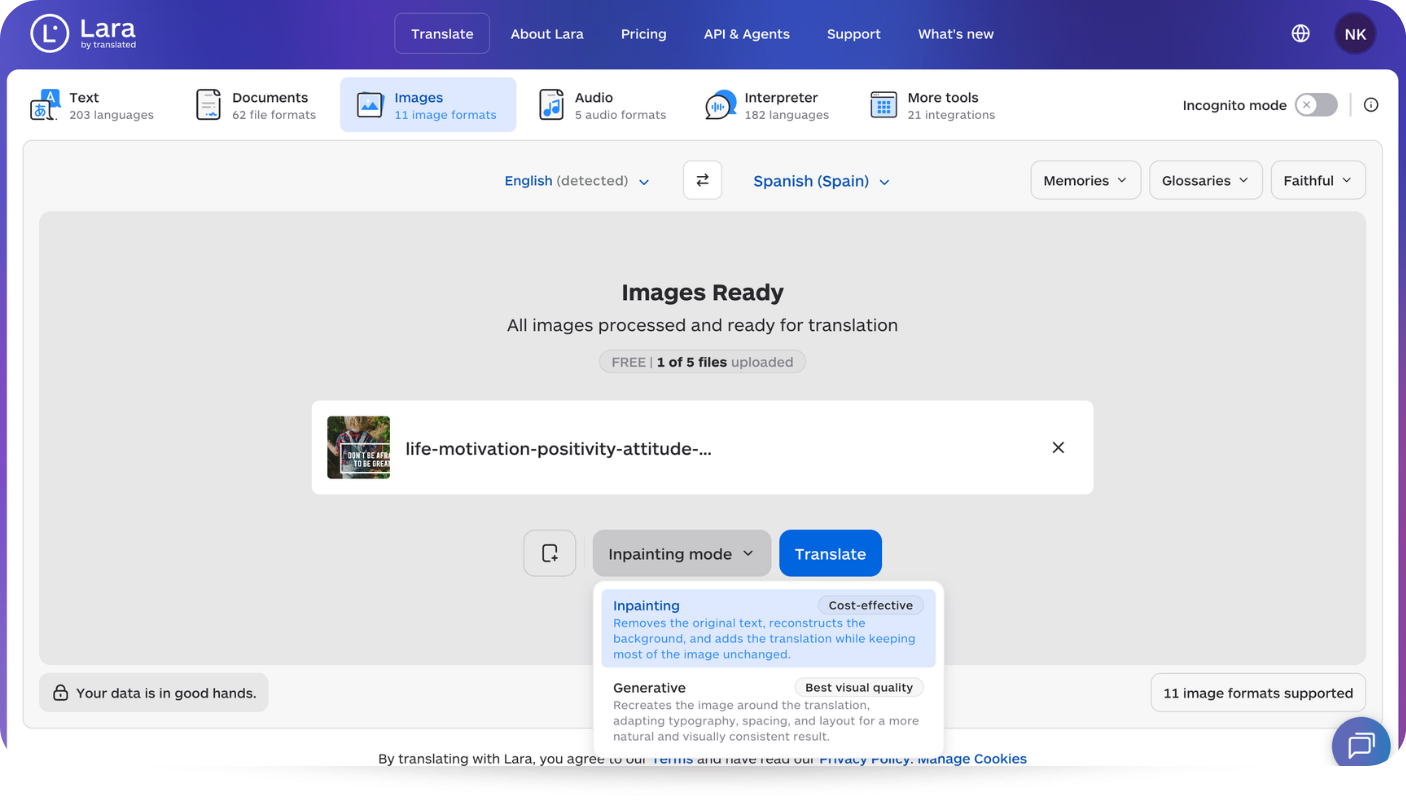
Passaggio 4: confrontala con l’originale, controllando nomi, numeri, unità di misura, testi in piccolo e posizione del testo.
Per i PDF, usa la traduzione di documenti e attiva Translate images quando il file contiene testo nelle immagini. La guida alla traduzione delle immagini nei PDF spiega come funziona questa opzione.
L’OCR rende il testo visivo utilizzabile oltre l’immagine
L’OCR risolve un problema pratico: dà al software accesso a parole che altrimenti resterebbero parte di un’immagine. Questa capacità conta ogni volta che lavori con archivi scansionati, screenshot, PDF basati su immagini, scontrini, cartelli o altri contenuti visivi con informazioni da riutilizzare.
Per i contenuti multilingue, Lara Translate unisce l’OCR alla propria tecnologia di traduzione per gestire le immagini supportate e il testo incorporato nei PDF. Invece di estrarre a mano il testo di partenza e tradurlo a parte, puoi usare un unico flusso per riconoscere e tradurre il contenuto, mantenendo utilizzabile il risultato visivo.
Se lavori con screenshot, documenti scansionati, etichette di prodotto, PDF basati su immagini o altri contenuti visivi in più lingue, con Lara Translate gestisci riconoscimento e traduzione in un unico posto.
Gestisci i contenuti multilingue con Lara Translate
Se traduci documenti, contenuti scansionati o risorse visive, Lara Translate ti aiuta a gestire tutto in un unico flusso di traduzione.
Hai uno strumento, una risorsa o un’idea che potrebbe arricchire uno dei nostri articoli?
Scrivici a press@laratranslate.com
Saremo felici di valutarlo e di considerarlo per arricchire i contenuti per i nostri lettori! ✍️
FAQ
Qual è un esempio di OCR?
Un esempio comune di OCR è scansionare uno scontrino cartaceo ed estrarre come testo digitale informazioni come il nome del negozio, la data, gli articoli e il totale. Un altro esempio è usare l’OCR su un PDF scansionato per cercare un nome o una frase nel documento, invece di leggere ogni pagina a mano.
L’OCR è la stessa cosa dell’AI?
No, OCR e AI non sono la stessa cosa. L’OCR indica il compito di riconoscere il testo visivo e convertirlo in testo leggibile dalla macchina, mentre l’intelligenza artificiale copre una gamma molto più ampia di tecnologie e attività. I sistemi OCR moderni usano spesso machine learning o reti neurali, ma l’OCR può anche basarsi su metodi più tradizionali come il pattern matching e l’estrazione di caratteristiche.
L’OCR sa leggere la scrittura a mano?
Sì, alcuni sistemi OCR riconoscono la scrittura a mano, ma supporto e precisione variano in base a strumento, lingua, stile di scrittura e qualità dell’immagine. In genere la scrittura a mano è più difficile da riconoscere rispetto a un testo stampato chiaro, perché la forma delle lettere cambia molto da persona a persona. Ad esempio, Google Cloud Vision documenta il rilevamento della scrittura a mano come uno degli usi della sua funzione di rilevamento del testo nei documenti.
L’OCR può tradurre un testo?
No, l’OCR in sé riconosce ed estrae il testo, ma non ne traduce il significato in un’altra lingua. Di quel passaggio si occupa un sistema di traduzione. Alcuni strumenti di traduzione di immagini combinano le due tecnologie in un unico flusso. Ad esempio, Lara Translate usa l’OCR per estrarre il testo da un’immagine e poi lo traduce nella lingua di destinazione scelta.
L’OCR riconosce lingue diverse?
Sì, l’OCR può riconoscere più lingue e sistemi di scrittura, ma le lingue supportate dipendono dal motore OCR. Alcuni sistemi rilevano automaticamente le lingue supportate, altri ti permettono di indicare una lingua o un alfabeto per migliorare il riconoscimento. Non dare quindi per scontato che l’OCR supporti tutte le lingue allo stesso modo.
Qual è la differenza tra OCR e riconoscimento del testo?
L’OCR è un tipo di riconoscimento del testo focalizzato sull’individuare il testo in immagini, pagine scansionate, foto e contenuti visivi simili e convertirlo in testo leggibile dalla macchina. Il termine riconoscimento del testo (text recognition) è più ampio e a volte viene usato come sinonimo di OCR, soprattutto nella documentazione dei software.
L’OCR può estrarre il testo da un PDF?
Sì, l’OCR può estrarre il testo da un PDF quando il documento contiene pagine scansionate o testo nelle immagini. Il sistema OCR riconosce i caratteri nelle immagini delle pagine e li converte in testo leggibile dalla macchina.
Qual è la differenza tra OCR e traduzione?
L’OCR estrae il testo da un’immagine o da un documento scansionato e lo converte in testo leggibile dalla macchina. La traduzione trasforma quel testo da una lingua all’altra. In un flusso di traduzione di immagini, di solito viene prima l’OCR e poi la traduzione.
Di cosa parla questo articolo
- Cosa significa la sigla OCR e cos’è il riconoscimento ottico dei caratteri
- Come funziona l’OCR, dall’acquisizione dell’immagine alla post-elaborazione
- I principali tipi di OCR: OCR semplice, ICR, IWR e OMR
- Vantaggi e usi dell’OCR nei flussi di lavoro quotidiani e aziendali
- Come l’OCR supporta la traduzione di immagini e PDF scansionati
- Quali fattori influiscono sull’accuratezza dell’OCR
- Come Lara Translate usa l’OCR per tradurre immagini e documenti
Fonti
- AWS: What Is OCR? Optical Character Recognition Explained
- ABBYY Support: Checkmark Recognition (Optical Mark Recognition, OMR)
- Google Cloud Vision: Detect Handwriting in Images
- Kurzweil Technologies: Kurzweil Computer Products
- Lara Translate Blog: Image Translation: How to Translate Images Without Losing Meaning or Layout
- Lara Translate: Image Translation
- Lara Translate Blog: When to Translate a JPG vs. Extract Text (Image-to-Image vs. OCR)
- Lara Translate: Document Translation
- Lara Translate Developers: Translate Image
- Lara Translate Support: Translating Images Inside PDF Documents
- Lara Translate Support: Translating Images with Lara Image-to-Image
Questo articolo è stato realizzato dal team contenuti di Lara Translate. Lara Translate è una piattaforma di traduzione basata sull’AI sviluppata da Translated, con oltre 25 anni di esperienza nella traduzione professionale. Team e professionisti usano Lara Translate per tradurre il testo contenuto in immagini, documenti scansionati e PDF, in oltre 200 lingue e più di 60 formati di file.